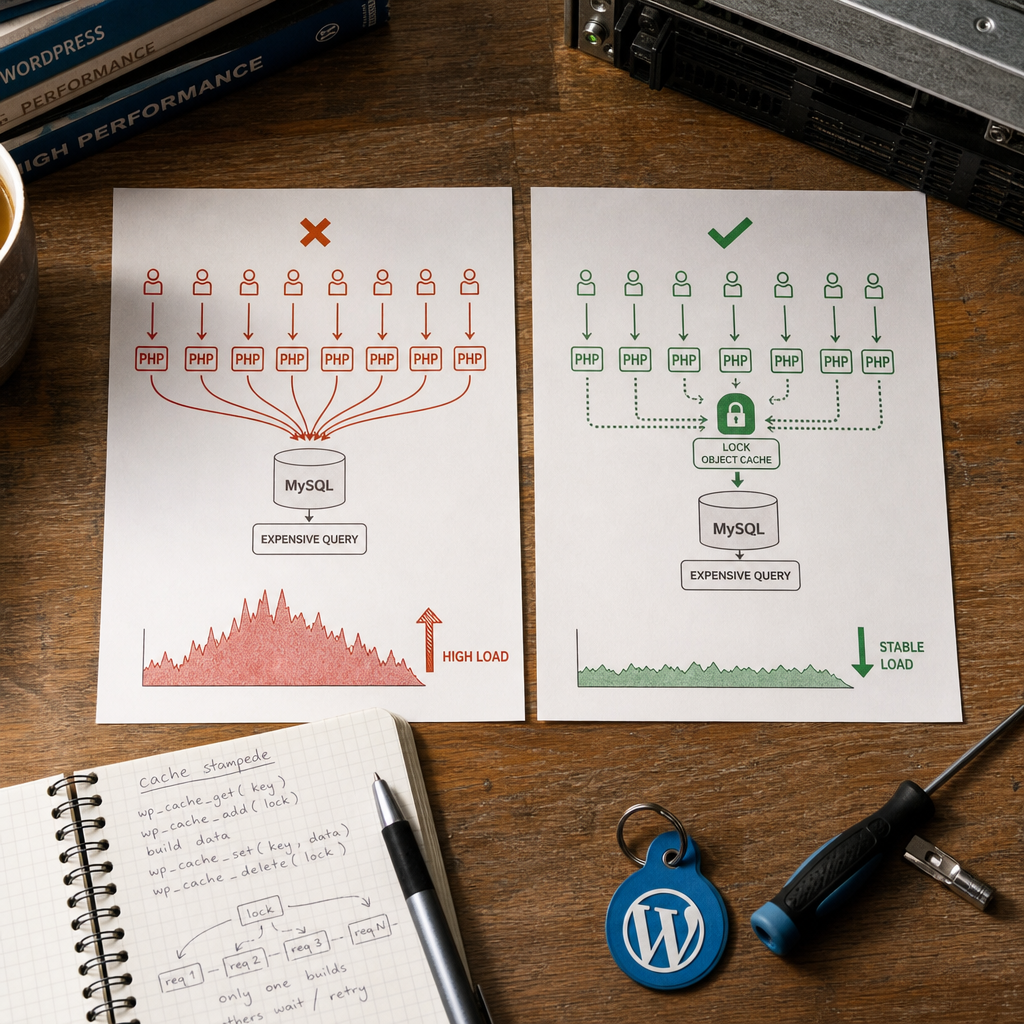
Cache stampede — це ситуація, коли термін дії популярного кешованого об’єкта завершується майже одночасно для великої кількості запитів. Кожен PHP-процес бачить порожній кеш і намагається самостійно виконати той самий важкий SQL-запит, звернутися до зовнішнього API або побудувати складний звіт.
У результаті кеш, який мав зменшувати навантаження, стає причиною піку на MySQL, PHP workers або API. У WordPress проблему зазвичай вирішують короткочасним lock у persistent Object Cache: лише один запит перебудовує дані, а інші використовують fallback, старе значення або чекають обмежений час.
Що таке cache stampede і як він виникає
Припустімо, популярний звіт зберігається в Object Cache протягом 5 хвилин. Після завершення TTL десятки або сотні одночасних запитів отримують cache miss. Якщо код не має захисту, кожен із них запускає my_build_report() і виконує однакову дорогу операцію.
Проблема особливо помітна на сторінках із високим трафіком, у REST API, під час масових cron-запусків і після очищення Redis або Memcached. Навіть якщо один SQL-запит не здається критичним, його паралельний запуск багатьма PHP-процесами може вичерпати підключення до бази даних.
- одночасне завершення TTL для популярного ключа;
- повторне виконання важких SQL-запитів;
- зростання кількості PHP workers і часу відповіді;
- пікове навантаження на MySQL або зовнішній API;
- ланцюгова реакція: повільна база даних уповільнює весь сайт.
Коли lock у Object Cache справді працює
Для захисту потрібен shared persistent object cache — зазвичай Redis або Memcached, підключений до WordPress через відповідний drop-in. Звичайний об’єктний кеш WordPress без persistent backend часто живе лише протягом одного PHP-запиту. У такому випадку різні запити не бачать спільний lock, і захист від cache stampede не працює.
Ключова операція — wp_cache_add(). Вона додає ключ лише тоді, коли такого ключа ще немає. За коректної роботи backend це дає змогу одному запиту отримати lock, а решті — зрозуміти, що перебудова вже виконується.
Перед впровадженням перевірте, що production-середовище справді використовує Redis або Memcached, а не лише встановлений плагін без активного drop-in. Також протестуйте поведінку після перезапуску PHP, очищення кешу та втрати з’єднання з backend.
- lock має бути короткочасним і мати TTL;
- ключ блокування повинен бути окремим для кожного дорогого об’єкта;
- TTL lock має покривати нормальну тривалість операції, але не зависати назавжди;
- один глобальний lock для всього сайту використовувати не можна.
Базова реалізація захисту в WordPress
Нижче наведено спрощений шаблон для звіту або іншої дорогої операції. Запит, який отримав lock, будує дані й записує їх у кеш. Інші запити не запускають ту саму операцію повторно: вони можуть скористатися запасним значенням або повторити читання після короткої паузи.
Група custom допомагає логічно відокремити ключі цього механізму. Назви ключів варто робити специфічними для об’єкта, сайту, мови або набору параметрів, якщо результат залежить від цих значень.
$key   = 'expensive_report:v1';
$group = 'custom';
$lock  = 'lock:' . $key;

$found = false;
$data  = wp_cache_get($key, $group, false, $found);

if (!$found) {
    // TTL lock має бути більшим за звичайний час побудови звіту.
    if (wp_cache_add($lock, 1, $group, 30)) {
        try {
            $data = my_build_report(); // SQL-запит або звернення до API

            if (false !== $data && null !== $data) {
                wp_cache_set($key, $data, $group, 300);
            }
        } finally {
            wp_cache_delete($lock, $group);
        }
    } else {
        // Інший запит уже перебудовує дані.
        $data = my_get_stale_report_or_fallback();
    }
}

return $data;
Чому не можна просто виконати операцію після cache miss
Перевірка кешу та запуск важкої функції без lock створюють race condition: кілька процесів одночасно бачать відсутній ключ. Саме wp_cache_add(), а не послідовність wp_cache_get() плюс wp_cache_set(), має бути операцією захоплення блокування.
Обробіть також помилки побудови даних. Якщо API повернув помилку або SQL-запит завершився невдало, не записуйте порожній чи некоректний результат на довгий TTL. Інакше тимчасовий збій стане закешованим результатом.
- використовуйте окремий lock для кожного набору параметрів;
- завжди задавайте TTL для lock;
- звільняйте lock у блоці finally, якщо це сумісно з вашою версією PHP;
- не вважайте значення false надійною ознакою cache miss без перевірки параметра found.
Що повертати запитам, які не отримали lock
Найкращий варіант залежить від типу даних і вимог до актуальності. Для каталогу, статистики або рекомендацій часто достатньо повернути попередню версію результату. Для критичних даних можна виконати повторне читання через коротку затримку, але таке очікування потрібно обмежувати, щоб не створити нову чергу PHP-процесів.
Практичний підхід — зберігати актуальний результат і його stale-копію під різними ключами. Якщо основний ключ порожній, а lock уже зайнятий, код повертає stale-значення. Користувач отримує швидку відповідь, а один фоновий або звичайний запит завершує оновлення.
Якщо fallback немає, поверніть безпечний порожній результат, HTTP-помилку або повідомлення про тимчасову недоступність — залежно від контексту. Гірше за контрольований fallback — запускати однаковий важкий запит у кожному процесі.
- stale-while-revalidate для даних, які можуть бути трохи застарілими;
- коротке повторне читання кешу для невеликих операцій;
- запасний результат із бази або локального конфігураційного значення;
- контрольований error response для критичних API-операцій.
TTL, jitter і захист від повторної хвилі запитів
Однаковий TTL для великої кількості ключів може створити кілька хвиль навантаження. Це трапляється, коли об’єкти були записані одночасно після очищення кешу або масового імпорту.
Для незалежних об’єктів можна додавати невеликий випадковий інтервал до TTL. Наприклад, базовий термін 300 секунд можна змінювати в межах кількох десятків секунд. Це розподіляє завершення терміну дії в часі, але не замінює lock: навіть при jitter один популярний ключ може одночасно запитуватися багатьма процесами.
TTL lock потрібно підбирати за реальною тривалістю операції. Якщо звіт зазвичай будується 3 секунди, 30 секунд може бути достатньо. Якщо інколи побудова триває довше за TTL, lock завершиться завчасно, і другий процес почне дублювати роботу.
- не використовуйте надто короткий TTL lock;
- не ставте надмірно довгий TTL, який затримує відновлення після падіння процесу;
- додавайте jitter до TTL даних, якщо багато ключів створюються одночасно;
- для дуже довгих задач розгляньте чергу або фонову генерацію замість очікування в HTTP-запиті.
$base_ttl = 300;
$jitter   = wp_rand(0, 30);
$ttl      = $base_ttl + $jitter;

wp_cache_set($key, $data, 'custom', $ttl);
Важливі обмеження та типові помилки
wp_cache_add() має сенс як атомарний lock лише тоді, коли конкретний persistent backend і drop-in коректно підтримують цю операцію. Не покладайтеся на поведінку локального тестового середовища, якщо production працює з іншим Redis або Memcached.
Просте видалення lock після завершення операції також має нюанс: якщо побудова тривала довше за TTL, lock міг уже перейти іншому запиту. Перший процес після завершення може видалити lock нового власника. Для найвищих вимог потрібен backend-специфічний механізм перевірки власника й атомарного видалення, наприклад операція на рівні Redis. У типовому WordPress-коді мінімізуйте цей ризик правильним TTL і не допускайте надто довгих синхронних задач.
Не використовуйте один ключ lock для всіх звітів або всього сайту. Повільний звіт тоді заблокує незалежні операції. Водночас надмірно деталізовані ключі можуть створити багато паралельних перебудов, тому область блокування потрібно визначати за реальною вартістю операції.
- не плутайте Object Cache із page cache: lock має бути доступним усім PHP-процесам;
- не записуйте результат у кеш після помилки або неповної відповіді API;
- не робіть нескінченний polling у запиті користувача;
- не очищуйте весь Redis через один проблемний ключ, якщо можна видалити лише потрібну групу або версію ключа.
Як перевірити, що захист працює
Перевірку проводьте в умовах, близьких до production. Спочатку переконайтеся, що повторне читання одного ключа справді повертає дані з Redis або Memcached. Потім очистіть конкретний ключ і створіть паралельні запити до endpoint або сторінки, яка запускає дорогу операцію.
У логах тимчасово фіксуйте захоплення lock, cache hit, cache miss, тривалість побудови, fallback і помилки backend. Під час тесту очікується один запуск my_build_report(), а не окремий запуск для кожного паралельного запиту.
Окремо перевірте сценарії повільного SQL, помилки API, перезапуску Redis, завершення PHP-процесу та перевищення TTL lock. Моніторинг має показувати не лише кількість cache hit, а й час відповіді, кількість підключень до MySQL та частоту перебудови популярних ключів.
- перевірте активність persistent object cache у production;
- порівняйте кількість cache miss із кількістю фактичних перебудов;
- перевірте поведінку при одночасних запитах після очищення ключа;
- відстежуйте lock timeout і випадки спрацювання fallback;
- переконайтеся, що збій кеша не запускає неконтрольовану лавину SQL-запитів.
Поширені запитання
Чи захистить wp_cache_add() від cache stampede без Redis або Memcached?
Ні, не гарантовано. Для різних PHP-запитів потрібне спільне persistent-сховище. Якщо Object Cache працює лише в межах одного запиту, процеси не бачитимуть спільний lock.
Яким має бути TTL для lock?
Він має бути довшим за нормальний час виконання дорогої операції, але обмеженим, щоб lock автоматично зник після аварії. Орієнтуйтеся на виміряну тривалість побудови та додайте запас.
Чи можна змусити всі інші запити чекати завершення перебудови?
Можна виконати кілька коротких повторних читань із паузою, але це потрібно обмежити. Для більшості сторінок безпечніше повернути stale-значення або fallback, ніж утворити чергу PHP-процесів.
Чи достатньо додати випадковий TTL замість lock?
Ні. Jitter зменшує ймовірність одночасного завершення TTL для різних ключів, але не вирішує проблему, коли один популярний ключ одночасно запитують десятки процесів.
Що робити, якщо операція триває довше, ніж TTL lock?
Збільште TTL після вимірювань, оптимізуйте SQL або API-запит і розгляньте фонову генерацію через чергу. Також врахуйте ризик повторного захоплення lock після його передчасного завершення.
Висновок
Захист від cache stampede у WordPress складається з трьох частин: shared persistent Object Cache, атомарного захоплення lock і коректної поведінки запитів, які lock не отримали. Один процес перебудовує дорогі дані, а решта використовує stale-результат, fallback або коротке повторне читання.
Почніть із перевірки Redis або Memcached, розділіть lock-ключі за конкретними об’єктами, задайте реалістичний TTL і додайте спостереження за cache miss та фактичними перебудовами. Це допоможе зменшити піки навантаження на MySQL без створення нового вузького місця в PHP.